코딩 AI의 새 모델 발표를 보면 점수와 속도, 비용이 함께 등장합니다. 실제 업무에서는 여기에 한 가지를 더 붙여 볼 수 있습니다. ‘내가 정한 완료 조건을 만족한 작업이 몇 건인가’입니다. 2026년 9월 10일 공개된 Cognition의 SWE-2 소식을 바탕으로, 발표 수치를 읽는 방법과 팀에서 사용할 평가표를 정리합니다.
공식 발표에서 확인된 내용
Cognition은 SWE-2를 코딩 작업을 위한 모델로 소개하며 FrontierCode 1.1 Main 50.0%, DeepSWE 1.1 73.0% 등의 결과를 공개했습니다. 이 수치는 회사가 발표한 벤치마크 결과입니다. 또한 작업에 투입하는 추론 수준을 조절하는 여러 effort 설정을 설명했습니다. 발표 시점에는 Devin Desktop과 CLI에서 이용을 시작하고 Web의 Fusion 경로는 순차 적용한다고 안내했습니다.
추론 수준은 모델이 작업을 해결할 때 얼마나 탐색하고 검토할지에 관한 설정으로 이해할 수 있습니다. 설정을 높였을 때의 실제 시간과 비용, 결과는 작업 종류에 따라 직접 확인할 필요가 있습니다. 벤치마크 이름과 버전이 다르면 문제 구성도 다를 수 있으므로, 숫자만 나란히 놓기보다 평가 조건부터 읽습니다.
점수 옆에 붙여 볼 다섯 가지 질문
| 확인 항목 | 읽을 내용 | 내 업무와 연결할 질문 |
| 문제 종류 | 저장소 수정·명령 실행 등 | 우리 팀의 작업과 비슷한가? |
| 도구 환경 | 제공된 도구와 실행 조건 | 같은 검증을 수행할 수 있는가? |
| 추론 설정 | 사용한 effort 수준 | 실제 이용할 설정과 같은가? |
| 완료 기준 | 테스트·채점 방식 | 사람이 확인할 항목은 무엇인가? |
| 비용 범위 | 실행 비용에 포함된 항목 | 재시도와 검토 시간도 기록했는가? |
이 질문은 공개된 결과를 어떤 범위에서 활용할 수 있는지 이해하기 위한 읽기 순서입니다. 예를 들어 명령줄 작업이 많은 팀과 UI 조정이 많은 팀은 동일한 모델에서도 서로 다른 작업 묶음으로 사용성을 확인할 수 있습니다.
팀에서 해 볼 수 있는 작은 비교 실험
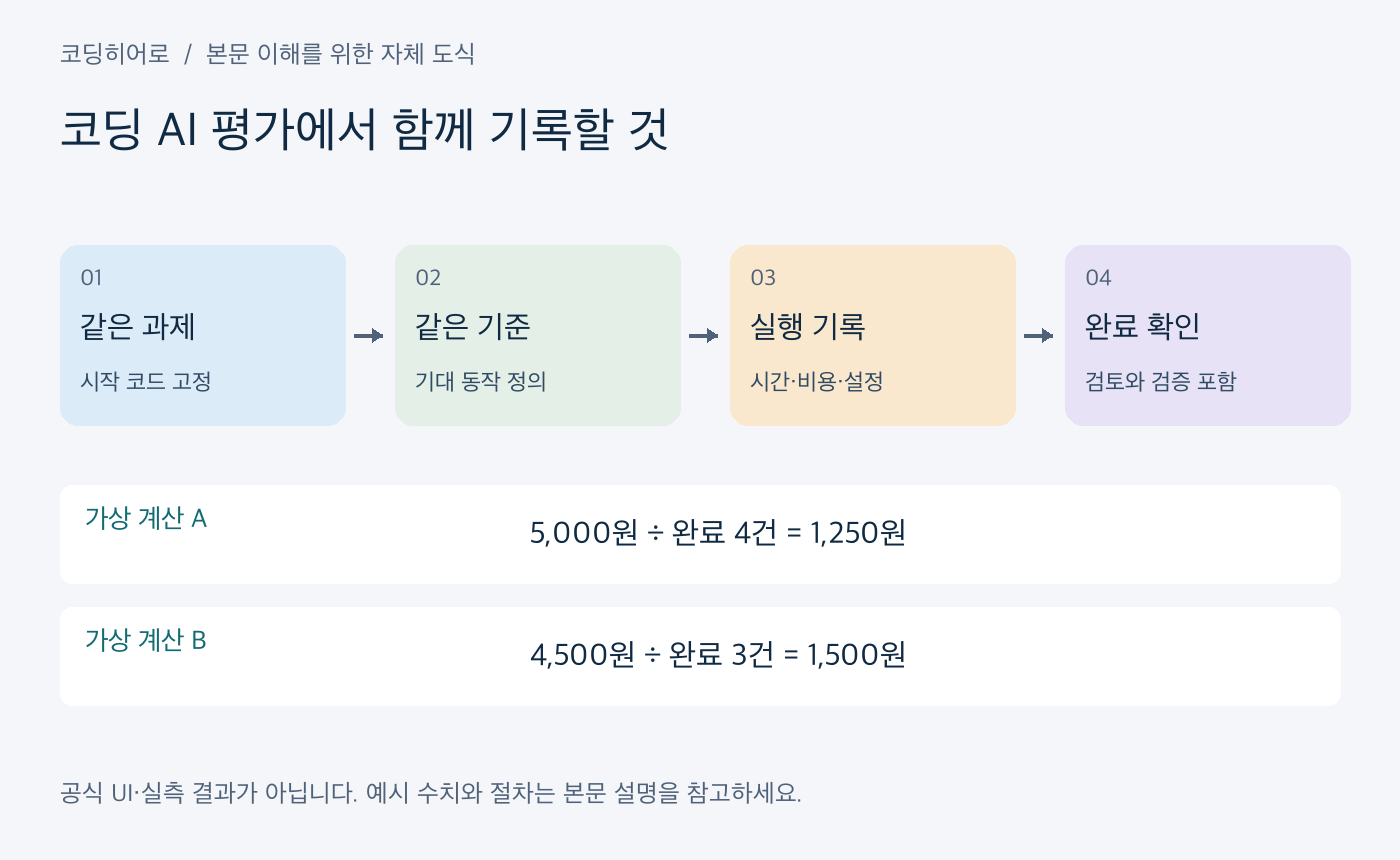
아래는 이 글에서 구성한 평가 방법입니다. 먼저 실제 업무를 닮은 과제 세 개를 고릅니다. 문서 한 곳 수정, 작은 계산 함수 변경, 두 모듈에 걸친 동작 변경처럼 범위를 구체적으로 적습니다. 모든 실행은 같은 시작 코드와 요구사항을 사용하며, 각 과제의 완료 조건을 실행 전에 정합니다.
| 과제 예시 | 미리 정할 완료 조건 | 사람이 보는 항목 |
| 설치 안내 보완 | 명령과 경로가 실제 구조와 일치 | 처음 읽는 사람의 이해 가능성 |
| 계산 함수 수정 | 예시 입력의 기대 결과 만족 | 경계값·숫자 처리 방식 |
| 두 모듈 연동 | 관련 동작과 회귀 경로 확인 | 수정 범위·기존 사용 방식 |
문서 과제를 점검할 때는 코드 테스트 개수보다 명령과 경로가 실제 환경에서 맞는지 봅니다. 동작 변경은 관련 테스트와 기존 흐름을 함께 확인합니다. 과제에 맞는 검증을 사용하면 ‘검사를 많이 실행했다’와 ‘요구한 결과를 확인했다’를 구분해 기록할 수 있습니다.
완료한 작업당 비용 계산 예시
비용을 비교할 때는 실행 횟수와 채택 가능한 결과를 함께 적어 봅니다. 예를 들어 한 설정에서 다섯 번 실행해 사용 비용 5,000원, 조건을 만족한 결과 네 건을 얻었다면 비용은 건당 1,250원입니다. 다른 설정에서 세 번 실행해 4,500원, 완료 세 건이라면 건당 1,500원입니다. 모두 계산법을 설명하기 위한 가상 수치입니다.
이 예시만으로 설정의 우열을 결정하지는 않습니다. 사람이 검토한 시간과 작업의 복잡도도 함께 적어야 합니다. 비용이 낮은 실행에서도 검토 시간이 길 수 있고, 작업이 복잡할 때는 추가 탐색이 도움이 될 수 있습니다. 지출 합계, 완료 건수, 검토 시간을 각각 기록하면 팀의 우선순위에 맞게 선택할 수 있습니다.
‘완료’라는 단어를 구체화합니다
코드가 작성된 상태, 테스트를 통과한 상태, 실제 사용 흐름을 확인한 상태, 운영 환경에 적용된 상태는 기록에서 각각 나눕니다. 예를 들어 로그인 화면의 문구를 바꿨다면 화면에 해당 문구가 표시되는지 확인합니다. 서버의 권한 처리를 바꿨다면 허용 사용자와 허용되지 않은 사용자의 응답을 각각 확인합니다.
업무 요청문에는 ‘수정 파일, 바뀐 동작, 실행한 검증, 아직 확인하지 않은 조건을 정리해 주세요’라는 항목을 넣을 수 있습니다. 이 네 가지가 있으면 검토자는 작업 결과를 다음 단계로 넘길 수 있는지 판단하기 쉽습니다. 설명이 없는 성공 문장보다 범위가 붙은 결과 기록이 인수에 유용합니다.
어떤 설정부터 써 보면 좋을까요?
짧고 완료 조건이 분명한 작업 하나를 고른 뒤 기본 설정으로 결과를 기록합니다. 이후 같은 과제를 다른 추론 수준으로 실행해 소요 시간과 완료 여부를 비교합니다. 이때 앞선 실행의 수정 결과를 다음 실행의 시작 코드에 섞지 않아야 비교 조건이 유지됩니다. 실제 운영 코드는 별도 작업 공간에서 보호합니다.
SWE-2 발표는 코딩 모델의 성능을 살펴볼 기회인 동시에, 팀의 완료 기준을 정리할 계기입니다. 벤치마크는 출발 자료로 활용하고, 최종 선택에는 내 작업의 요구사항·검토 시간·완료 비용을 함께 남겨 보세요.
공식 발표 확인: 2026년 9월 17일. 벤치마크는 개발사 발표 수치이며, 비용 및 과제 예시는 자체 제작한 설명 자료입니다.
출처: https://cognition.com/blog/swe-2
'AI 뉴스·업데이트' 카테고리의 다른 글
| GPT-6 Astra 발표: 화면 조작·코딩·사이버 능력을 업무에 나누어 읽기 (0) | 2026.09.18 |
|---|---|
| Jev 공개: 글을 쓰지 않고 판단만 돌려주는 모델, 어디에 붙일까 (0) | 2026.09.18 |
| Claude 소상공인 지원 확대: 43개 워크플로를 내 가게의 주간 업무로 바꾸는 법 (0) | 2026.09.18 |
| Cognition·AWS 협력 발표: 기존 시스템을 옮길 때 먼저 준비할 테스트 자료 (0) | 2026.09.18 |
| Claude에서 Salesforce 업무를 이어간다: 37개 영업 스킬과 승인 절차 읽기 (0) | 2026.09.17 |


댓글